这个方向有什么用?
模型给出答案很容易,难的是让人敢相信这个答案。
银行凭什么冻结我的账户?
风控系统判定账户异常时,必须给用户和监管一个说得清的理由,不能只说“模型觉得可疑”。对应研究:可解释性——自动找出支持判决的证据。
骗子学会“装正常”怎么办?
诈骗者会故意伪装行为模式来骗过检测模型,数据里也充满噪声和缺失。对应研究:鲁棒性——让模型在干扰和攻击下依然稳定。
从没见过的新型骗局怎么识别?
诈骗手法不断翻新,模型不能只认识训练时见过的那几种。对应研究:泛化性——识别未知异常、只用极少样本完成检测。
我们在研究什么
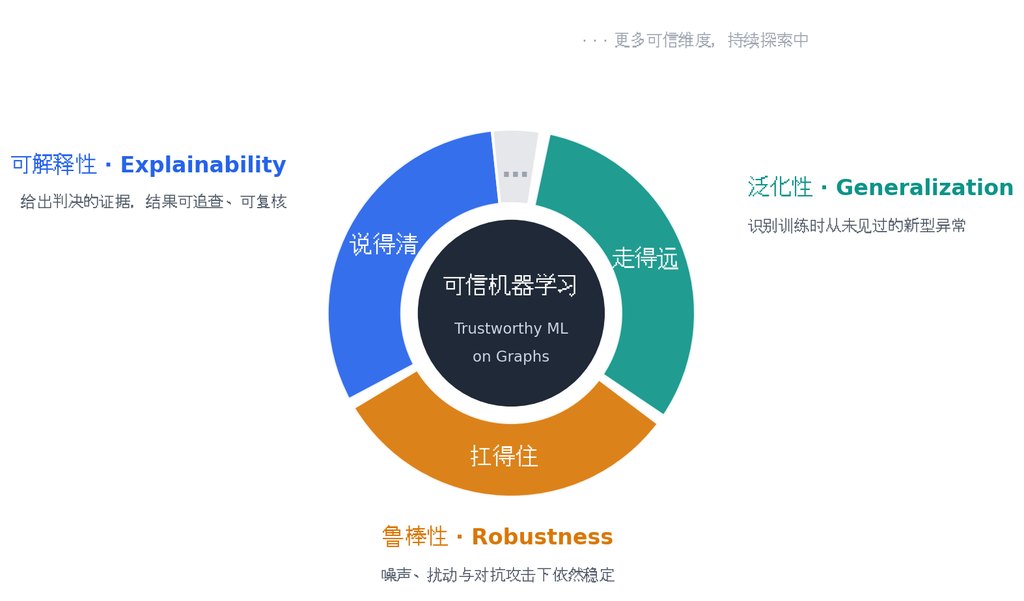
三个维度,共同回答一个问题:这个结果凭什么可信?
01可解释 · 说得清
不只给出“异常”的判决,还给出判决的依据:定位证据子图,并通过边级反事实证据校准回答“改动哪条边,结论就会改变”,让解释精确到证据级别。
02鲁棒 · 扛得住
真实数据充满噪声、缺失与对抗扰动。研究扰动与攻击下的稳定性评估与防御方法,保证模型在数据质量下降时仍然可靠。
03泛化 · 走得远
面向训练时没见过的新节点、新边与新型异常:研究归纳式检测、开放场景未知异常识别与少样本检测,让模型走出训练集后仍然有效。
代表性成果
本方向近年的部分论文与项目。
Invariant Graph Representations for Continuous-Time Dynamic Graphs Under Distribution Shifts
Lanting Fang, Yulian Yang, Yawei Zhang, Shanshan Feng, Kaiyu Feng, Hanning Yuan
IJCAI 2026 · CCF B分布漂移下泛化
Unseen Anomaly Detection from System Logs
Yanni Tang, Zhuoxing Zhang, Lanting Fang, et al.
SIGMOD 2026 · CCF A未知异常检测
Anonymous Edge Representation for Inductive Anomaly Detection in Dynamic Bipartite Graphs
Lanting Fang, Kaiyu Feng, Jie Gui, Shanshan Feng, Aiqun Hu
VLDB 2023 · CCF A归纳式泛化检测
AnomalyLLM: Few-shot Anomaly Edge Detection for Dynamic Graphs using Large Language Models
Shuo Liu, Di Yao, Lanting Fang, et al.
ICDM 2024 · CCF B少样本检测
动态图异常检测的稳定性与可解释性研究
国家自然科学基金(面上项目)· 2025–2028 · 负责人:方兰婷
在研项目
在研课题 · Demo
课题面向研究生与优秀本科生开放,Demo 与代码将陆续上线。